收藏了几千份资料,为什么需要时还是找不到?
收藏一份好资料的时候,人很容易产生一种满足感:我已经学到了。
看到一篇好文章,保存;收到一份 PDF,导入;开完一场会,转写;刷到一个有启发的视频,再剪藏。
资料越来越多,文件夹越来越满,知识库的数字也越来越漂亮。
可真正遇到问题时,你输入一个关键词,系统返回二十条相似结果。标题都眼熟,内容也都像看过,但你不知道应该先信哪一份,更不知道哪一份能直接解决眼前的问题。
收藏解决的是“我怕以后找不到”,知识管理解决的却是“我现在就要用”。
这两件事之间,隔着一整套加工过程。
把资料放进去,只完成了仓储
很多知识库本质上只是一个更高级的网盘。
原文、摘要、会议记录、个人观点、FAQ、操作手册和 AI 生成内容全放在一起。搜索时,它们拥有几乎相同的地位,于是你得到的不是答案,而是一桌没有标签的食材。
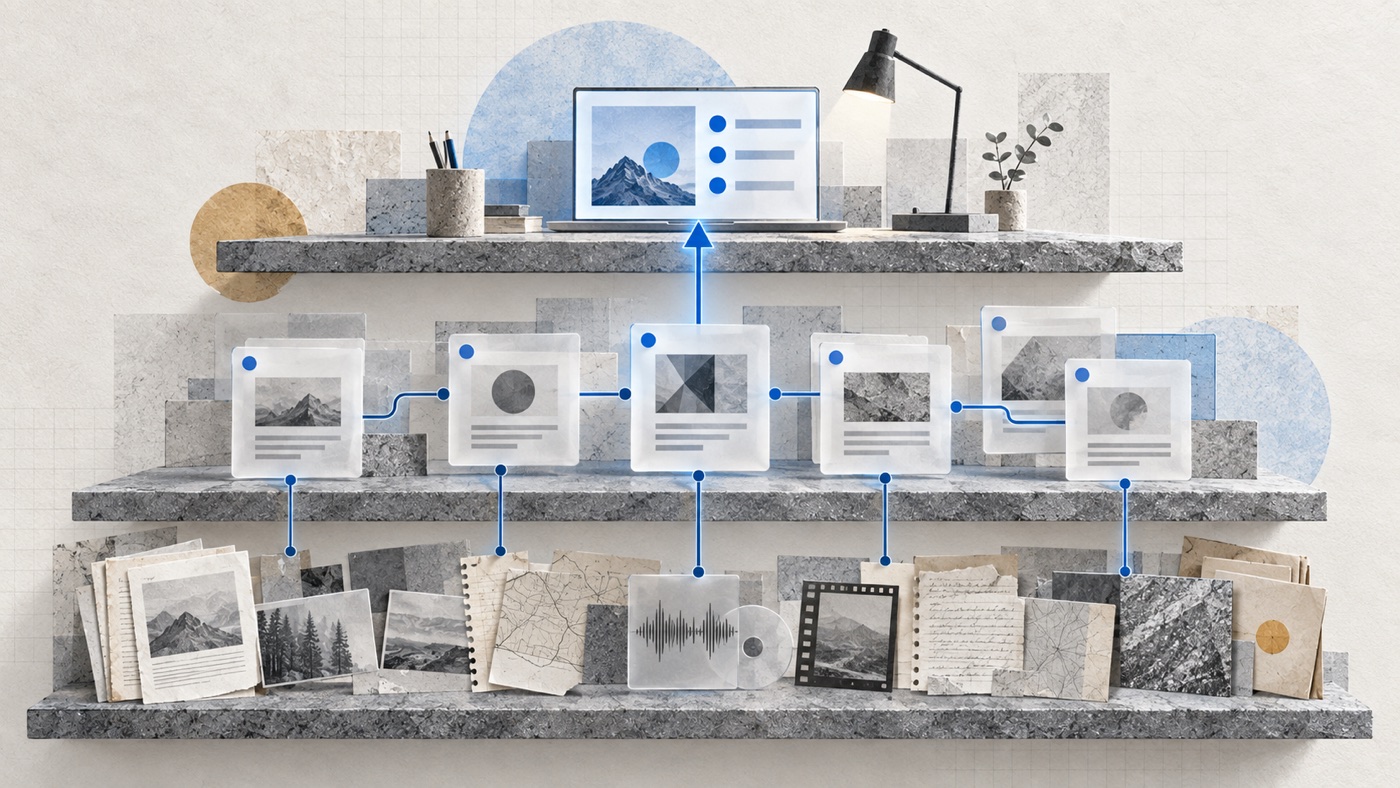
WorkBuddy 的档案管理、知识卡片、问答萃取等技能,给出了一个很朴素的共同思路:不要继续堆目录,而要把知识库分成三层。
你可以把它们理解为:仓库、加工台和工作台。
第一层:仓库——保留没有被改写的证据
这一层放会议记录、网页、PDF、语音转写、业务数据和历史文件。
它的任务只有一个:尽可能保留原貌。
原文可以做 OCR,可以转写,可以加标签,但不要因为某句话看起来不顺,就在整理时顺手改掉。需要纠正时,新增注释和修订记录,而不是覆盖原始内容。
同时保留来源、采集时间、文件标识和权限。以后摘要有争议、规则发生变化,所有人还能回到这里重新核对。
原始材料不一定正确,但它必须真实地保留“当时是怎么说的”。
第二层:加工台——把材料变成可复用的知识
原文通常太长,也不适合直接解决问题。第二层要做的是清洗、去重、拆分和归类。
不同内容,需要被加工成不同的知识单元:
- 一条规则,要写清条件、结论、例外和版本。
- 一个 FAQ,要有标准问题、标准答案和常见问法。
- 一个案例,要保留问题、判断、行动、结果和教训。
- 一套方法,要说明适用条件、操作步骤和常见坑。
这里最重要的一条原则是:每个知识单元都要保留通往原文的路。
摘要不是新的事实来源,知识卡也不是孤立的小作文。它们只是把原始材料加工成更容易理解、更容易调用的形态。
第三层:工作台——围绕具体任务重新组织
真正被人使用的,往往不是原始文档,而是专题索引、SOP、培训手册、问答助手,或者给 AI Agent 使用的任务视图。
这些内容可以根据场景重新组合,但不要再复制一套事实。
比如,同一条售后规则可能同时出现在新人培训、客户问答和质检清单里。正确做法不是复制三份,而是让三个应用视图都引用同一个权威知识单元。
规则变化时,只更新一个位置,其他视图重新生成。
否则最常见的结果就是:五份文档改了三份,剩下两份继续在搜索结果里误导人。
一个知识库,只能有一个事实源头
知识库失控,往往不是因为目录不够细,而是同一句话有太多副本。
原文里一份、个人笔记里一份、SOP 里一份、培训材料里一份、AI 总结里又一份。每个人都在认真维护自己的版本,最后反而没人知道哪一份算数。
三层结构真正解决的,不是“文件放哪儿更好看”,而是明确三种责任:
- 证据层负责保真。
- 知识层负责提炼。
- 应用层负责解决具体任务。
职责分开以后,工具可以换,模型可以升级,组织架构也可以调整,知识本身仍然能够迁移。
不必重建全部,先整理一个高频问题
面对几千份资料,最容易出现的反应是:我要重新设计一套完美目录。
通常没必要。
先挑一个每周都会被问到的问题,只做一次小实验:
- 找到与它有关的原始文件,放入证据层。
- 删除重复内容,提炼出规则、FAQ 和案例。
- 做一个能直接使用的 SOP 或问答页面。
- 从最终答案一路点回知识单元,再点回原文。
- 请一个真正需要它的人完成一次任务。
这条链路跑通了,再复制到下一个主题。比起花一个月重构全部目录,这种做法更快暴露真正的问题。
写在最后
知识库不是把世界上的资料搬进来,而是让重要的信息在正确的时间,进入正确的工作场景。
判断结构是否有效,只看三件事:原文找得到,知识能复用,修改只发生在一个权威位置。
做到这一步,收藏才不再只是缓解焦虑,资料才开始真正为你工作。